La navaja de Ockham aplicada a la seguridad del correo electrónico
Cómo aplicar el principio de parsimonia al análisis de correo electrónico sin caer en conclusiones precipitadas: partir de la explicación que requiere menos supuestos, contrastarla con las evidencias y aumentar la complejidad solo cuando los datos lo justifican.
Un correo sospechoso llega al buzón. El remitente parece legítimo, SPF pasa, DKIM también, el dominio tiene buena reputación y no existe ningún adjunto claramente malicioso. Sin embargo, el mensaje solicita modificar urgentemente una cuenta bancaria. ¿Estamos ante una sofisticada infraestructura diseñada para evadir todos los controles? ¿Una cuenta legítima comprometida? ¿Una suplantación? ¿O simplemente ante un mensaje legítimo que ha despertado una alerta por su contenido?
En seguridad del correo electrónico es fácil construir rápidamente una teoría compleja. Cuantos más datos tenemos disponibles, más tentador resulta intentar relacionarlos todos. La navaja de Ockham ofrece una forma diferente de abordar el problema: empezar por la explicación que necesita menos supuestos y aumentar la complejidad únicamente cuando las evidencias lo justifican.
¿Qué es la navaja de Ockham?
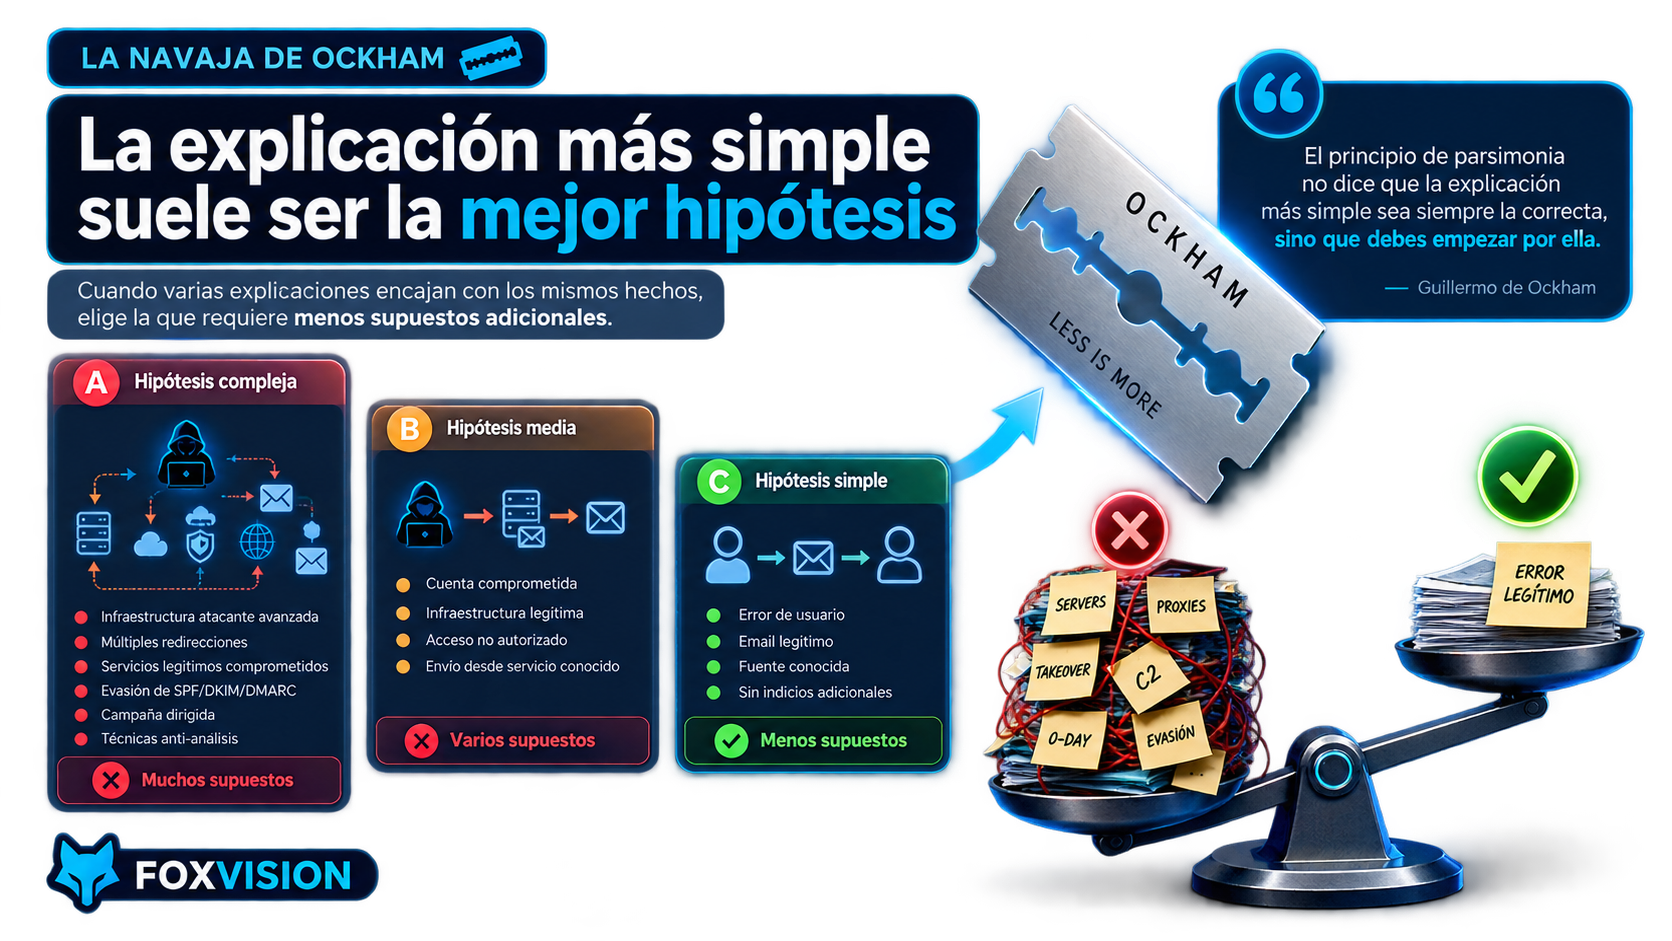
La navaja de Ockham, también denominada principio de parsimonia, se asocia al filósofo medieval Guillermo de Ockham. Aplicada de forma práctica, propone que cuando varias hipótesis explican adecuadamente las mismas evidencias, resulta razonable comenzar trabajando con aquella que necesita introducir menos supuestos adicionales.
Esto no significa que la explicación más sencilla sea siempre la correcta. Tampoco constituye una prueba. Es una heurística para ordenar hipótesis y evitar añadir complejidad innecesaria antes de que las evidencias obliguen a hacerlo.
Ockham entra en el SOC
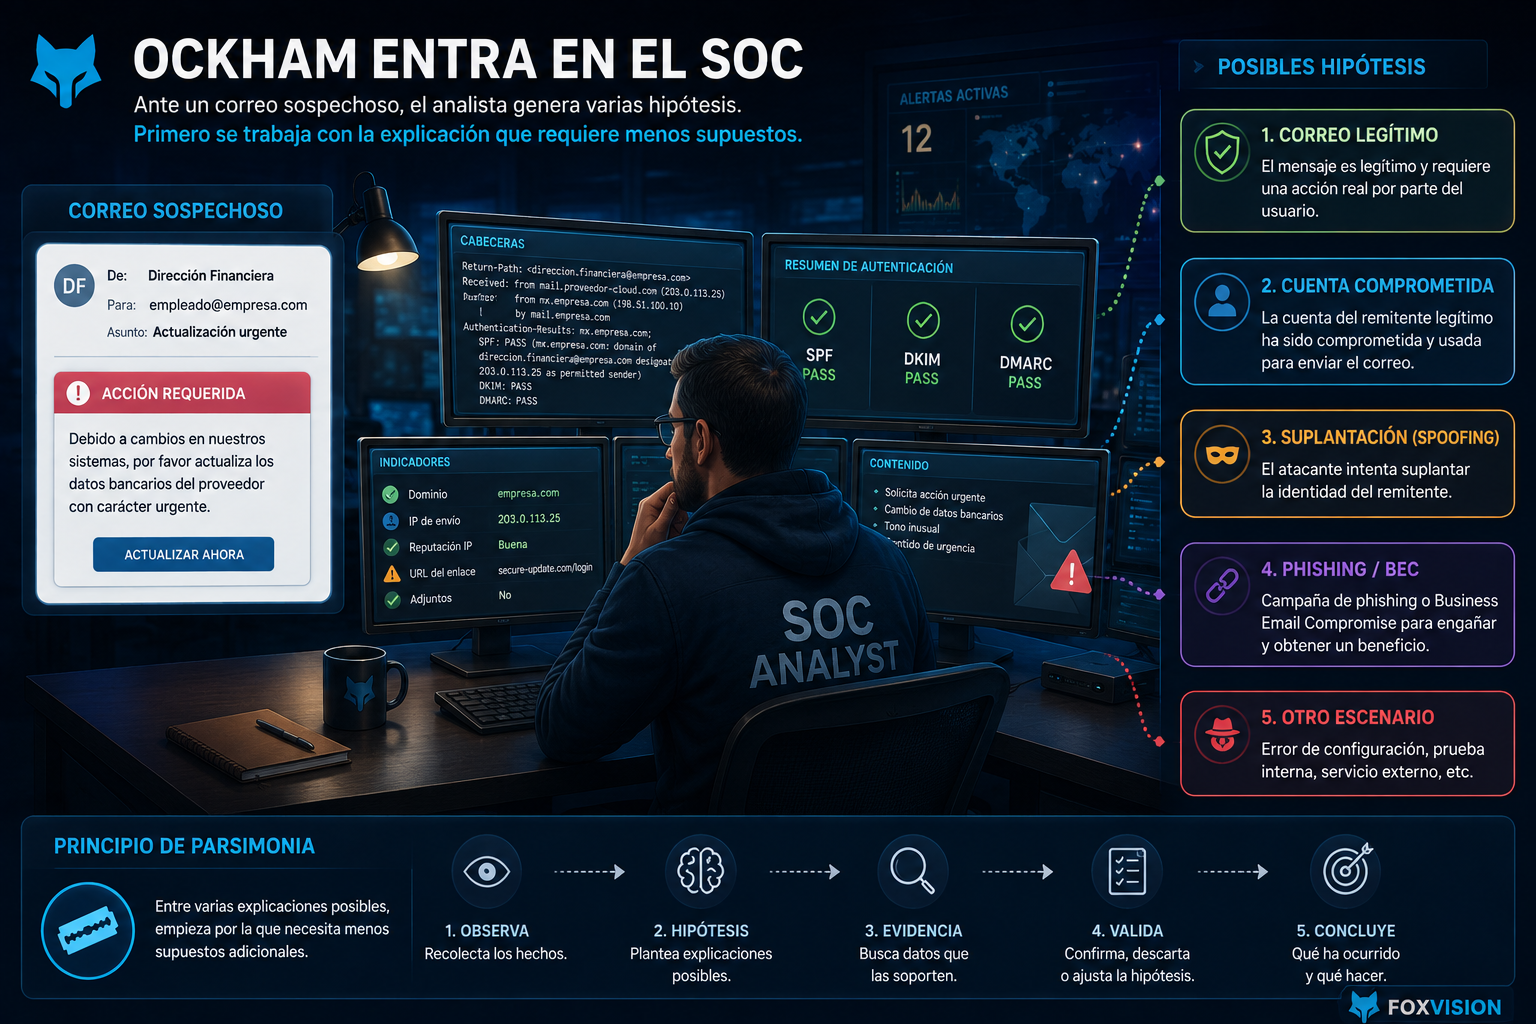
Un analista de seguridad trabaja continuamente con hipótesis. Una alerta proporciona observaciones y el analista intenta determinar qué secuencia de acontecimientos puede explicarlas.
En Email Security esto ocurre constantemente. Un mensaje puede presentar una URL desconocida, un dominio recién observado, una anomalía de autenticación, una dirección IP inesperada o una discrepancia entre diferentes identidades del remitente. Cada elemento abre nuevas posibilidades.
El problema aparece cuando una posibilidad se transforma demasiado pronto en una explicación. Que algo pueda ocurrir no significa que haya ocurrido.
De la observación a la hipótesis
Imaginemos un correo que aparentemente procede de una empresa conocida pero falla SPF.
Una primera hipótesis podría ser que el mensaje es una suplantación del dominio. Pero también podría existir un servicio legítimo enviando correo en nombre de la organización, un problema de configuración SPF, forwarding, una interpretación incorrecta de la identidad evaluada o simplemente una infraestructura que todavía no hemos identificado.
La aplicación de Ockham no consiste en seleccionar inmediatamente la explicación más cómoda. Consiste en evitar construir una cadena compleja de acontecimientos cuando todavía existe una explicación más sencilla compatible con las evidencias.
Un fallo de SPF no significa phishing
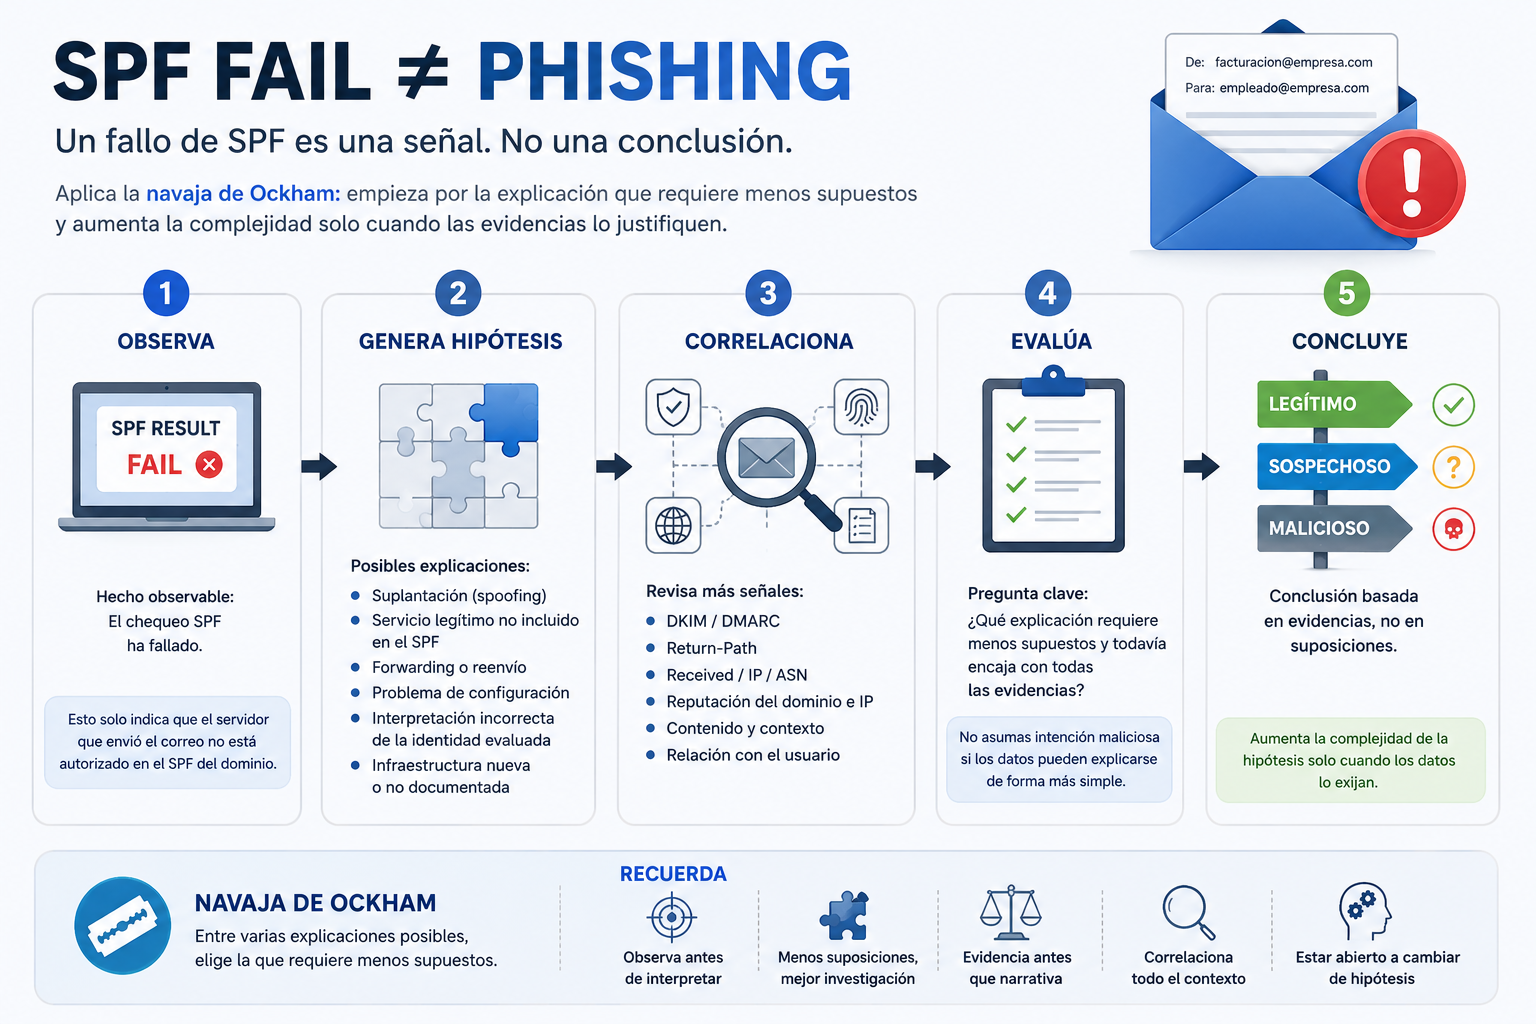
Este es un buen ejemplo del valor del principio de parsimonia. Si observamos SPF=fail, la evidencia disponible permite afirmar que la comprobación SPF realizada para la identidad correspondiente no ha superado la validación.
No permite concluir automáticamente que existe phishing.
Para avanzar necesitamos más información: Return-Path, From, DKIM, DMARC, Received, Authentication-Results, infraestructura de envío, dominio, contenido y contexto del mensaje.
Si después aparecen otras anomalías coherentes entre sí, la hipótesis de suplantación gana fuerza. No porque fuera inicialmente la explicación más atractiva, sino porque nuevas evidencias han reducido las explicaciones alternativas.
SPF, DKIM y DMARC: pasar autenticación no significa correo seguro
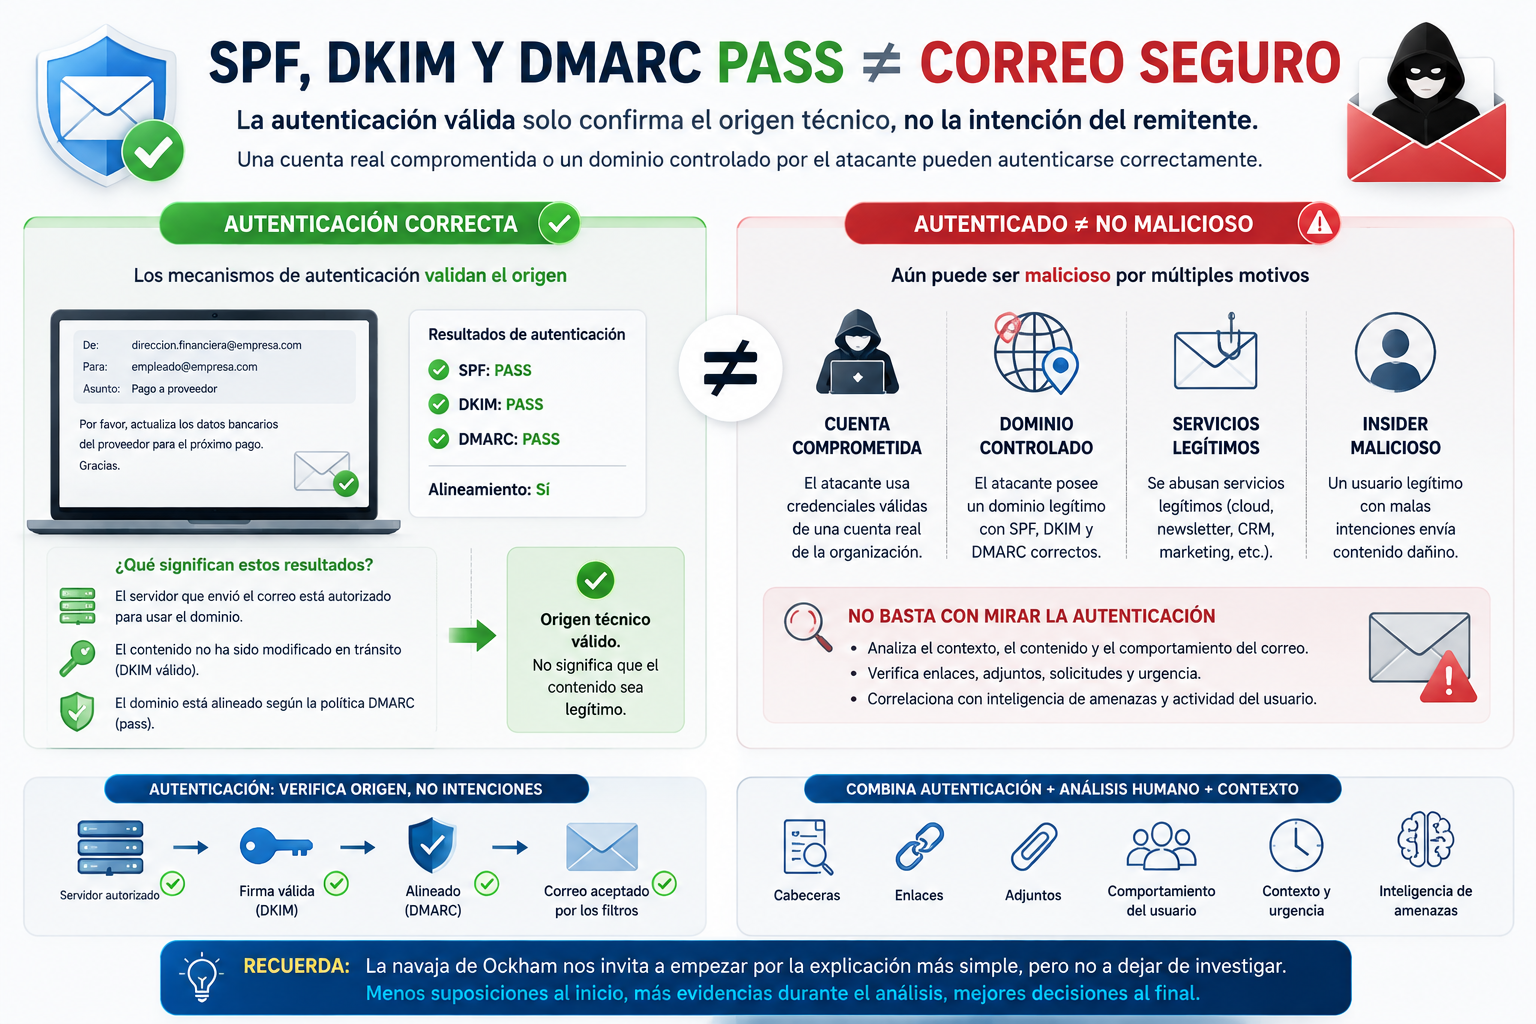
También puede producirse el escenario contrario. Un mensaje supera SPF, DKIM y DMARC y, aun así, resulta malicioso.
Ante un mensaje autenticado tendemos a pensar que el remitente es seguro. Pero estos mecanismos responden a cuestiones concretas sobre autenticación y alineamiento del correo; no certifican que las intenciones de quien controla una cuenta, dominio o infraestructura sean legítimas.
Si una cuenta real ha sido comprometida, un atacante puede enviar correo desde infraestructura autorizada. Si utiliza un dominio controlado por él y correctamente configurado, también puede obtener resultados válidos de autenticación.
Ockham vuelve a resultar útil: no necesitamos imaginar inicialmente una evasión criptográfica sofisticada si la evidencia puede explicarse mediante el abuso de una identidad o infraestructura legítimamente autenticada.
El extraño caso del correo que no llegó
Otro escenario habitual en operaciones de Email Security es una incidencia del tipo: el correo no ha llegado.
Es fácil comenzar pensando en bloqueos avanzados, problemas de reputación, listas de denegación, errores de DMARC, reglas complejas del gateway o fallos de routing.
Pero antes conviene comprobar lo elemental: ¿el servidor remitente intentó realmente entregar el mensaje?, ¿existe una conexión registrada?, ¿tenemos un Message-ID?, ¿se produjo un rechazo SMTP?, ¿el destinatario era correcto?, ¿el mensaje fue aceptado y entregado?, ¿terminó en cuarentena o en otra carpeta?
Buscar inicialmente la explicación que requiere menos supuestos evita dedicar tiempo a investigar una cadena compleja cuando el mensaje quizá nunca llegó a la infraestructura que estamos analizando.
Cabeceras: leer antes de interpretar
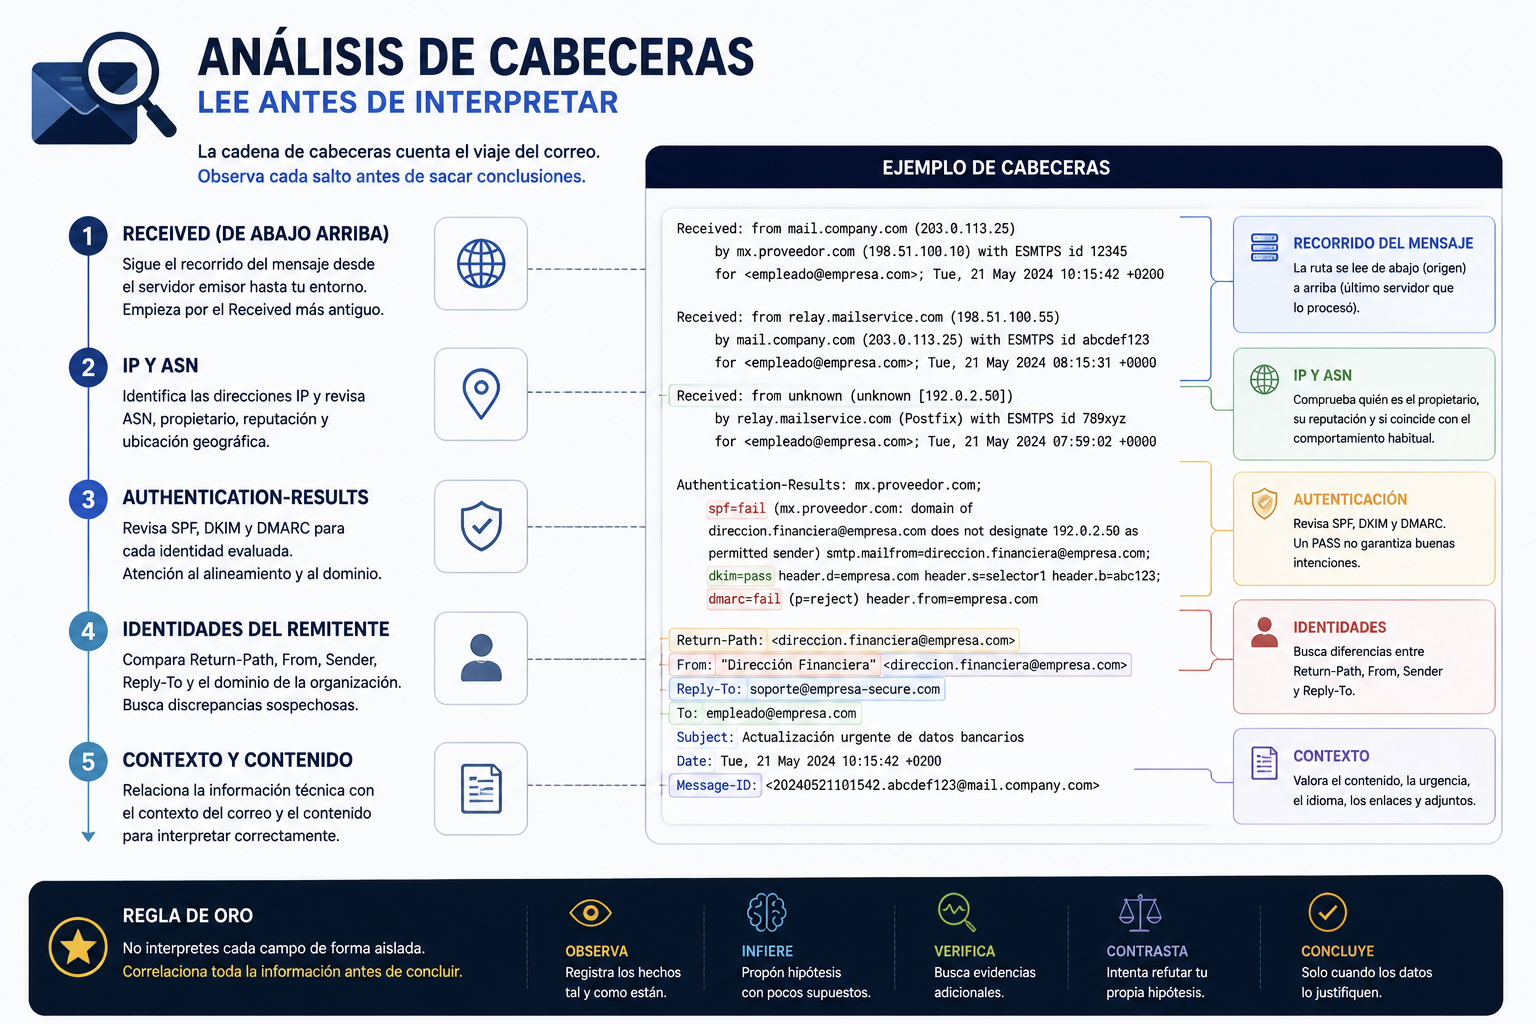
Las cabeceras de un correo proporcionan una gran cantidad de información, pero también pueden fomentar el sobreanálisis.
Una dirección IP desconocida en un Received no implica necesariamente infraestructura atacante. Puede pertenecer a un relay, proveedor cloud, servicio de marketing, gateway intermedio o infraestructura legítima que todavía no hemos identificado.
El procedimiento debería comenzar separando observación e interpretación.
Observación: aparece una dirección IP que no reconocemos en la cadena Received.
Hipótesis: podría pertenecer a infraestructura no habitual.
Validación: analizamos ASN, propietario, posición dentro de la cadena, DNS, contexto y relación con el resto de la infraestructura.
Solo después de esa validación podremos aumentar o reducir la confianza en la hipótesis.
Una URL desconocida tampoco es automáticamente maliciosa
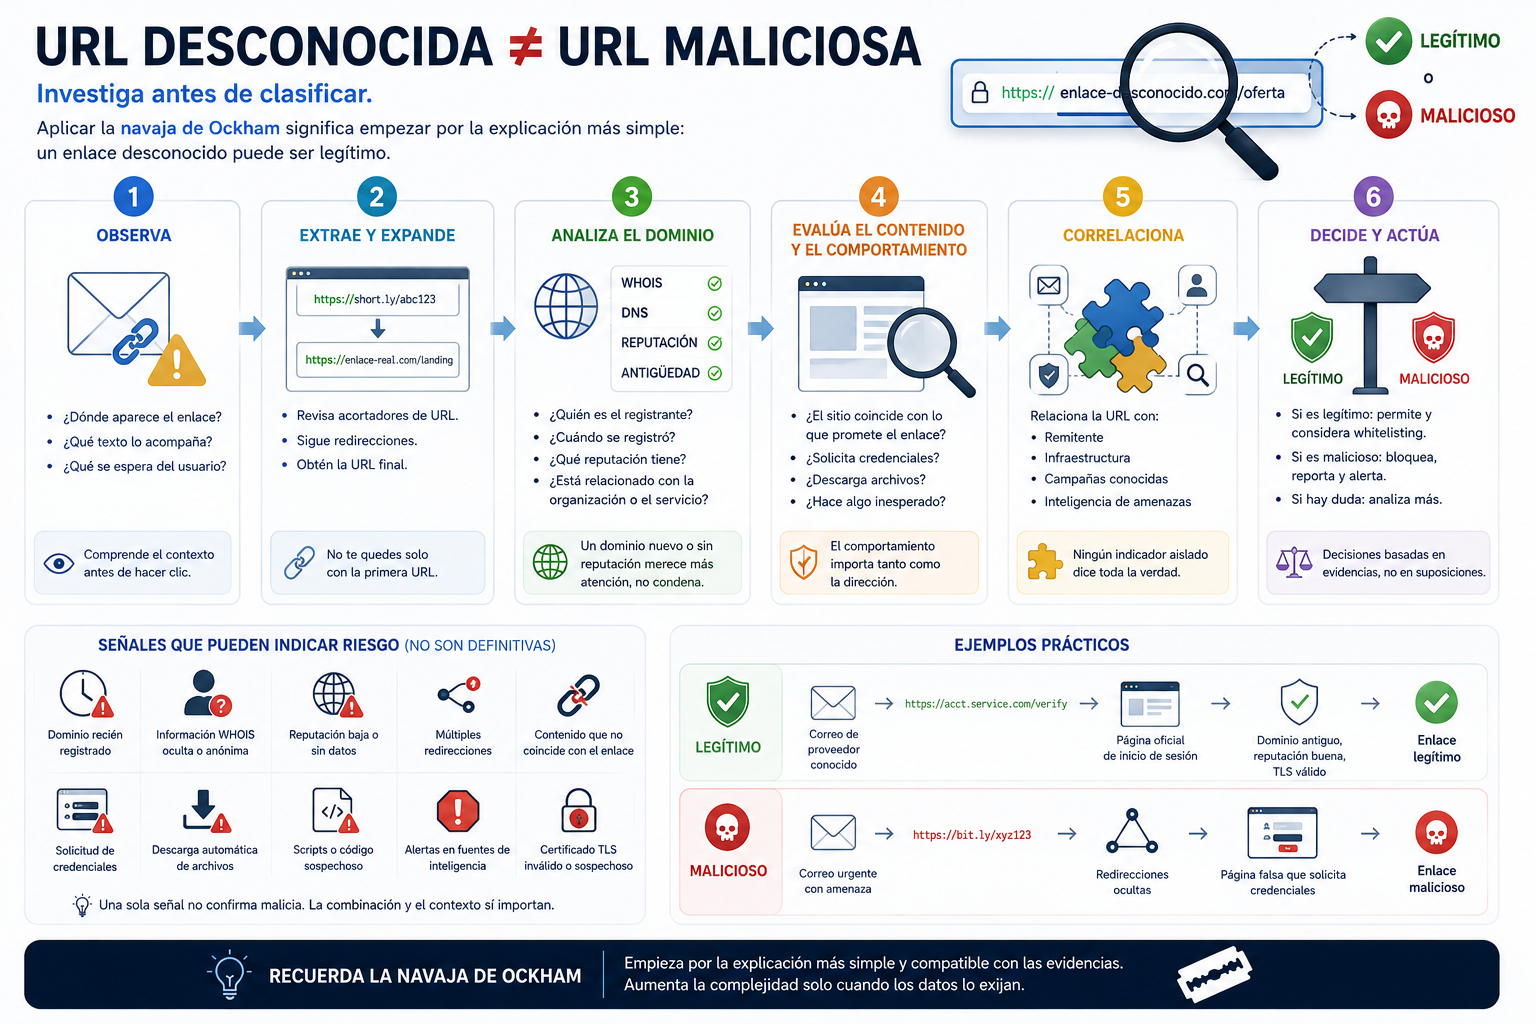
La misma lógica se aplica a las URLs. Encontrar un dominio desconocido dentro de un correo puede justificar una investigación, pero desconocido y malicioso no son sinónimos.
Antes de construir una hipótesis de phishing conviene analizar el dominio, las redirecciones, el contexto, la relación con el remitente y otros indicadores disponibles.
Si el enlace pertenece a un servicio legítimo utilizado por la organización, esa explicación requiere menos supuestos que imaginar inicialmente una infraestructura atacante diseñada específicamente para imitar dicho servicio. Si las evidencias posteriores contradicen esa explicación, se descarta y se continúa con la siguiente hipótesis.
El adjunto detectado como malware
Supongamos ahora que un gateway detecta un adjunto como malicioso.
Una interpretación precipitada podría describir inmediatamente una campaña de malware dirigida contra la organización. Sin embargo, inicialmente solo sabemos que un control ha clasificado un archivo como malicioso o sospechoso.
La investigación debe determinar qué es el archivo, qué detección se ha producido, si existen otras observaciones, cuál es su hash, de dónde procede, si fue entregado, si llegó a ejecutarse y si existen evidencias posteriores en endpoint, identidad o red.
La complejidad de la conclusión debe crecer al mismo ritmo que la evidencia.
Evidencia antes que narrativa
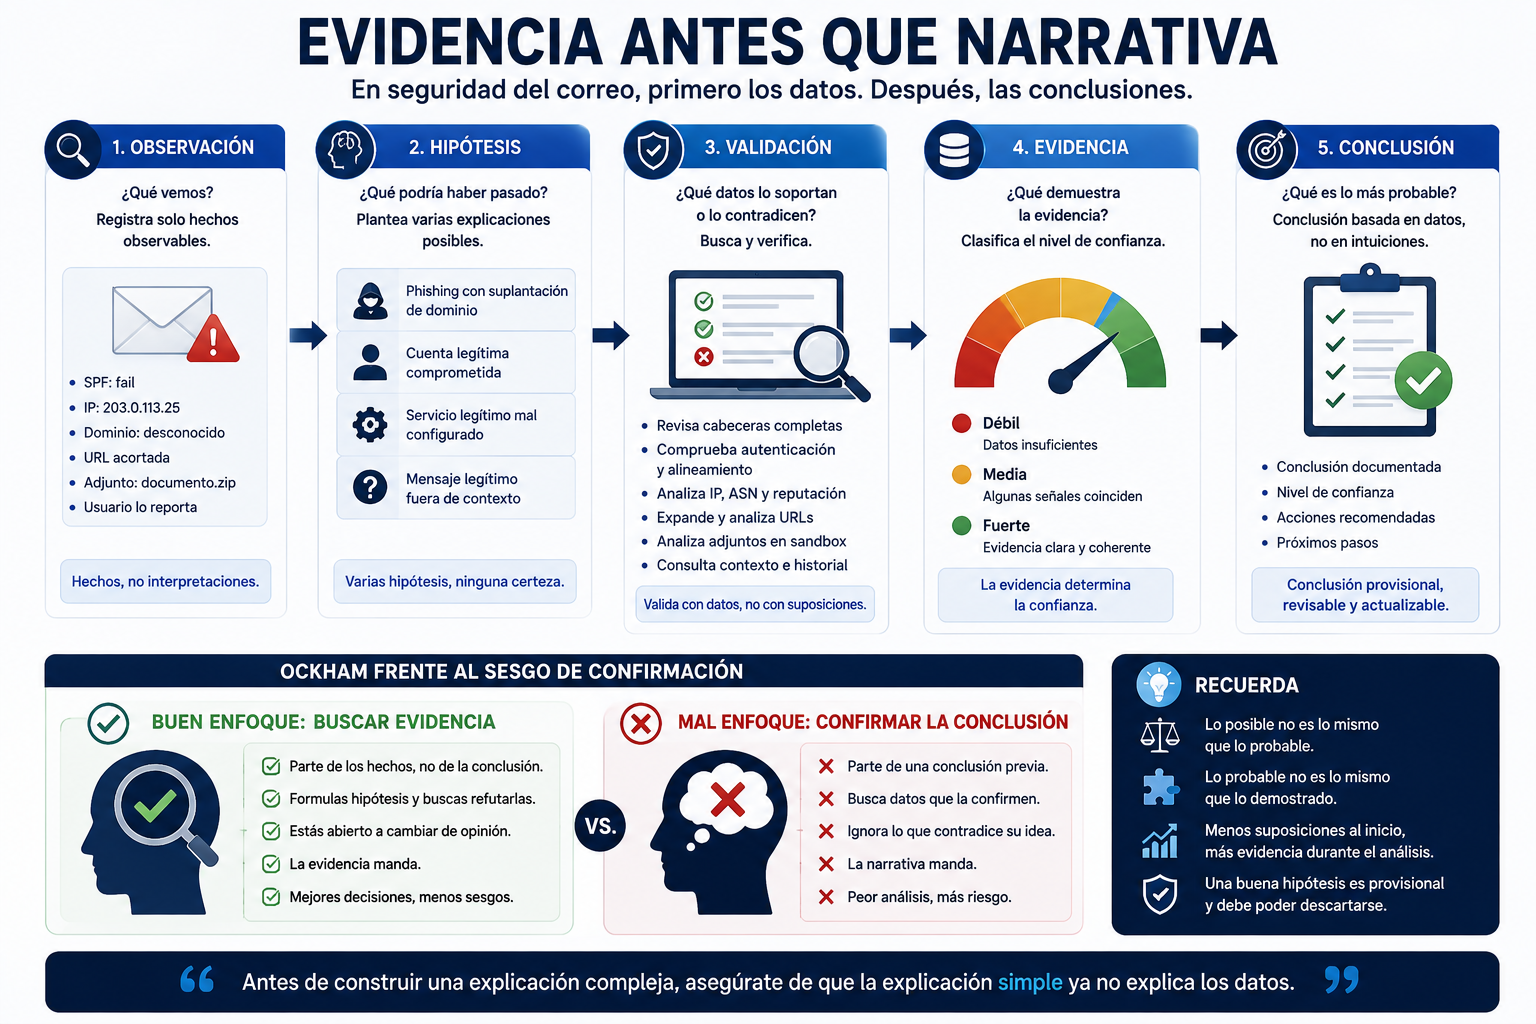
Una investigación puede entenderse como una sucesión de preguntas. Para cada una de ellas existen observaciones, hipótesis y evidencias que permiten confirmar, descartar o mantener abiertas diferentes posibilidades.
Un enfoque inspirado en la navaja de Ockham podría resumirse así: observar primero, formular la hipótesis que explique los datos con menos supuestos, intentar refutarla, buscar evidencias adicionales y aumentar la complejidad únicamente cuando la hipótesis sencilla deja de explicar lo observado.
Ockham no significa ignorar ataques sofisticados
Aplicar este principio incorrectamente también tiene riesgos. Un atacante puede utilizar varias capas de redirección, servicios legítimos, infraestructura comprometida, técnicas AiTM, cuentas previamente comprometidas o mecanismos diseñados específicamente para dificultar el análisis.
La navaja de Ockham no dice que debamos ignorar estas posibilidades. Dice que no deberíamos necesitarlas para explicar una evidencia cuando existe otra hipótesis igualmente compatible que requiere menos supuestos.
Si aparecen evidencias que la explicación sencilla no puede justificar, la investigación debe evolucionar. Una buena hipótesis es provisional y debe poder descartarse.
Ockham frente al sesgo de confirmación
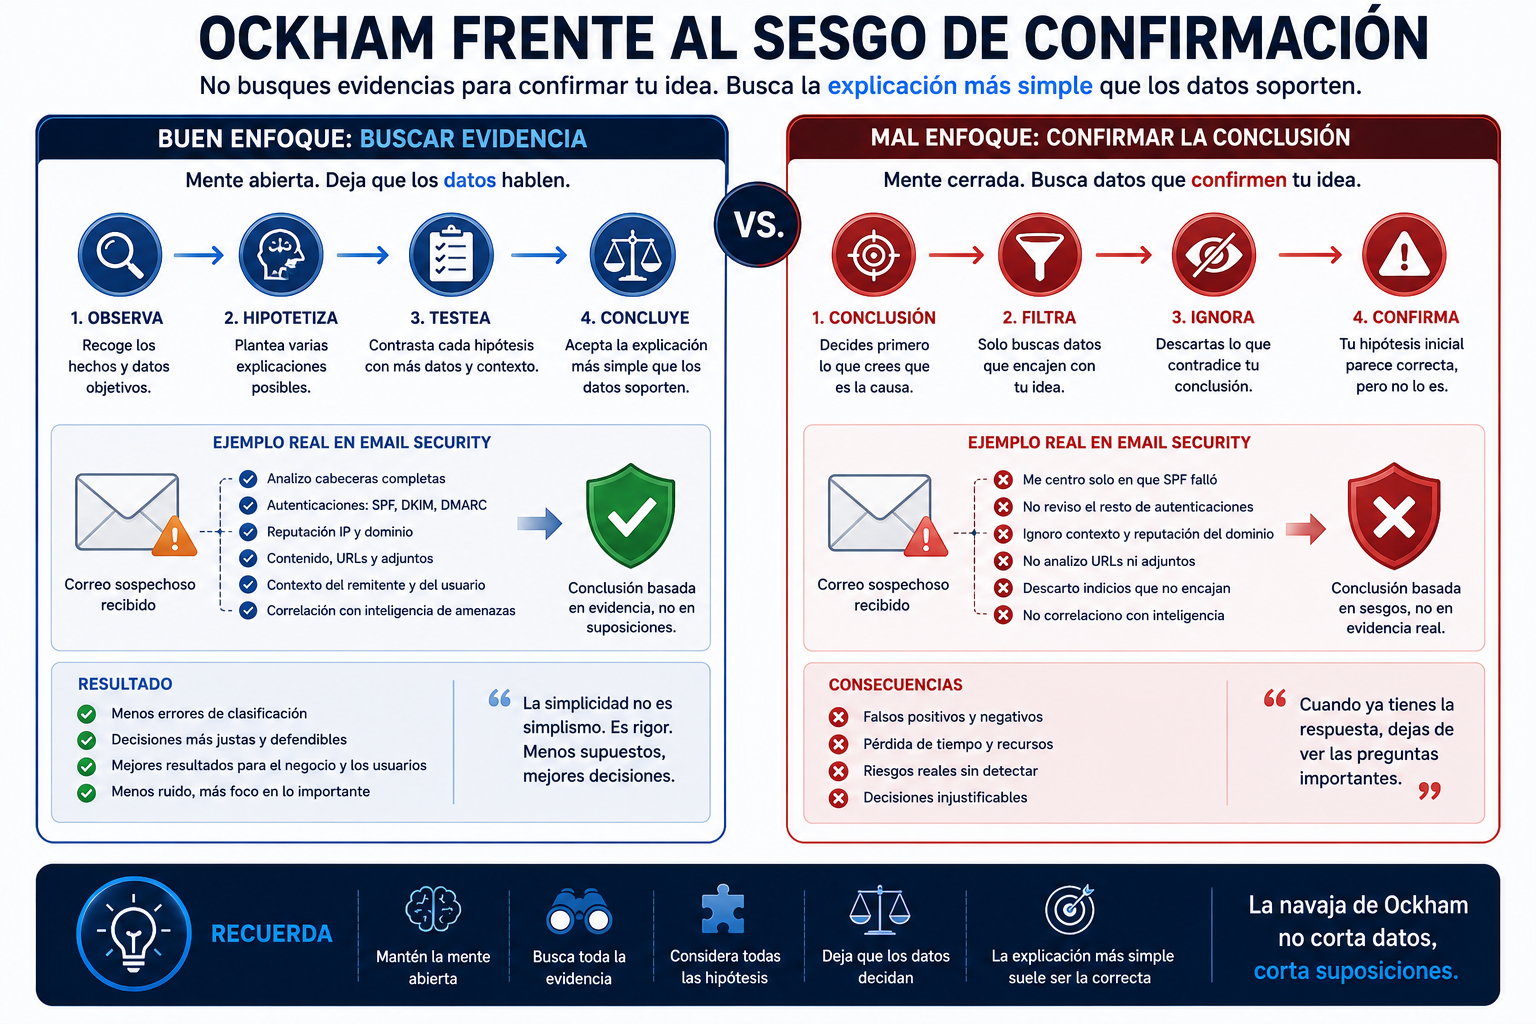
Existe además un beneficio importante: reducir el sesgo de confirmación.
Si un analista decide demasiado pronto que un correo es phishing, puede comenzar a interpretar cada elemento posterior como confirmación de esa conclusión. Una IP desconocida se convierte en infraestructura maliciosa; una URL poco habitual, en phishing; un fallo de autenticación, en spoofing; y una redirección, en evasión.
Pero también puede suceder lo contrario: decidir demasiado pronto que un mensaje es legítimo y racionalizar posteriormente todas sus anomalías.
Trabajar con hipótesis explícitas obliga a preguntarse qué evidencias podrían demostrar que nuestra explicación inicial es incorrecta.
Ejemplo: posible BEC
Un usuario reporta un correo del director financiero solicitando urgentemente modificar los datos bancarios de un proveedor.
La primera pregunta no debería ser qué grupo criminal está detrás del ataque. Primero necesitamos determinar si el mensaje es auténtico.
Podemos comprobar identidad del remitente, Authentication-Results, Message-ID, cadena Received, infraestructura utilizada, Reply-To, contexto de conversaciones anteriores y cualquier cambio respecto al comportamiento habitual.
Si el mensaje procede realmente de la cuenta corporativa del directivo, la hipótesis de spoofing pierde fuerza. Entonces aparecen otras posibilidades: la cuenta podría estar comprometida, el mensaje podría ser legítimo o podría existir otro mecanismo de fraude.
Cada nueva evidencia modifica el conjunto de hipótesis. La investigación avanza eliminando explicaciones, no acumulando suposiciones.
Metodología para Email Security
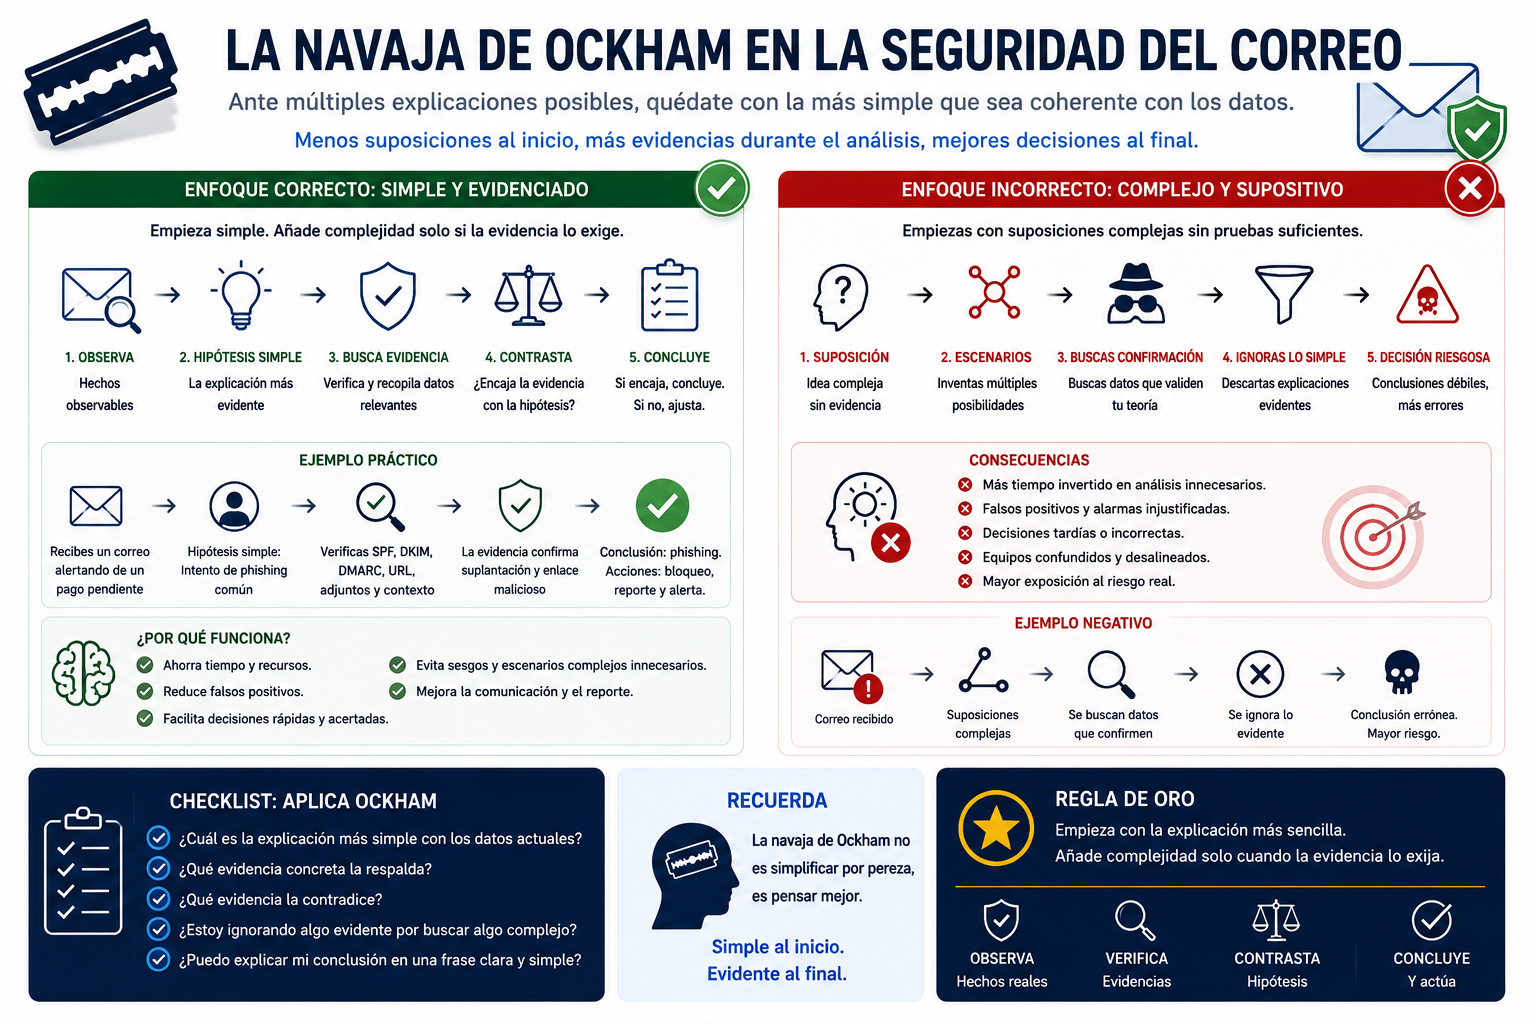
1. ¿Qué sabemos? Registrar únicamente hechos observables: resultados de autenticación, IP, dominios, URLs, hashes, timestamps, acciones del gateway y otros datos disponibles.
2. ¿Qué creemos que ha ocurrido? Formular una o varias hipótesis separadas de los hechos.
3. ¿Qué hipótesis necesita menos supuestos? Priorizar la explicación capaz de justificar las observaciones sin introducir elementos que todavía no han sido demostrados.
4. ¿Qué dato podría demostrar que estamos equivocados? Buscar activamente evidencias capaces de refutar la hipótesis.
5. ¿La explicación sigue encajando? Si aparecen contradicciones, abandonar o modificar la hipótesis.
6. ¿Necesitamos una explicación más compleja? Solo cuando los datos ya no puedan explicarse satisfactoriamente mediante las hipótesis anteriores.
La diferencia entre posible, probable y demostrado
En seguridad del correo esta distinción es fundamental.
Que una técnica sea técnicamente posible no significa que sea la explicación probable de un evento. Y que una explicación sea probable tampoco significa que haya sido demostrada.
Un buen análisis debería dejar claro qué elementos son hechos observados, cuáles son inferencias y qué conclusiones disponen de evidencia suficiente. Esta separación mejora tanto el trabajo del analista como la calidad del informe que recibirá posteriormente otro equipo.
Menos suposiciones, mejores investigaciones
La navaja de Ockham encaja especialmente bien con el análisis de seguridad porque obliga a controlar una tendencia muy humana: construir una historia antes de disponer de todas las evidencias.
En Email Security, una investigación eficaz no es necesariamente la que plantea la explicación más sofisticada. Es la que consigue explicar las evidencias disponibles introduciendo el menor número posible de supuestos y sabe abandonar esa explicación cuando aparecen datos que la contradicen.
SPF fail no significa automáticamente phishing. SPF pass no significa correo seguro. Una IP desconocida no significa C2. Una URL nueva no significa infraestructura maliciosa. Un adjunto detectado no demuestra por sí mismo una campaña dirigida.
Son observaciones. El trabajo del analista comienza precisamente ahí.
En seguridad, la explicación más sencilla no tiene por qué ser la correcta. Pero antes de construir una explicación compleja, deberíamos ser capaces de demostrar por qué la sencilla ya no explica las evidencias.
Fuentes y referencias
- Washington University in St. Louis – Keeping Information Security Simple: Occam, Hanlon, and Staying Paranoid
- NIST – Phishing Guidance
- NIST IR 8194 – Exploratory Lens Model of Decision-Making in a Potential Phishing Attack Scenario
- NIST SP 1800-6 – Domain Name System-Based Electronic Mail Security
- NIST SP 800-61r3 – Incident Response Recommendations and Considerations for Cybersecurity Risk Management